Поворот в не туда или Как написать тетрис не привлекая внимания санитаров

Locked
UR5FFR
Site Admin
Posts: 2365
Joined: 21 Apr 2012, 22:00
Позывной: UR5FFR
Location: Odessa

Поворот в не туда или Как написать тетрис не привлекая внимания санитаров

Post by UR5FFR »

Все началось с размышлений на тему «а что, если бы всё сложилось по-другому». Мои размышления как профессионального программиста, который пишет код уже 35+ лет, часто возвращаются к языку C. И к тому чудовищу под названием C++, которое он породил. Чудовище — потому что других слов подобрать невозможно: это сложный, запутанный и противоречивый монстр, который, несмотря на всё свое уродство, используется повсеместно. Потому что куча кода, совместимость и прочий легаси — горел бы он огнем.

Но язык C тоже не возник на ровном месте. Тут немного стоит углубиться в историю. Итак, изначально был PDP-7. И было у него машинное слово в 18 бит. Неожиданно? Да, но в 60-х никто такими вещами не заморачивался. И оперировал он только словами — то есть единицей доступа к памяти было слово. Байт еще не изобрели. Шутка, изобрели конечно :)
Небольшая ремарка о том, что из себя представляла PDP-7 внутри: аккумулятор, индексный регистр, еще один регистр данных — ну, собственно, и всё :) Теперь становится понятно, откуда содрали архитектуру 6800 и 6502 почти полностью
И тогда Ken Thompson создал для этой машины язык B. Вот просто так и назвал одной буквой — B. (Кстати, Кен — личность легендарная: вместе с Деннисом Ритчи работал над юниксом, разрабатывал UTF-8 и Go, и многое другое, но об этом не сейчас). Так вот, этот язык, если на него посмотреть, удивительно похож на известный всем C.

Code: Select all

main( ) {
  auto c;
  while (1) {
    while ( (c=getchar()) != ' ')
      if (putchar(c) == '*n') exit();
    putchar( '*n' );
    while ( (c=getchar()) == ' '); /* skip blanks */
    if (putchar(c)=='*n') exit(); /* done when newline */
  }
}
В чем отличие? Нет типов данных. Один тип данных — машинное слово. То самое, которое 18 бит :)

Но техника развивалась, и появилась знаменитая PDP-11. У нее слово было уже нормальные 16 бит. Целых 8 регистров, очень гибкая система адресации данных. По сравнению с PDP-7 — просто небо и земля. Но что еще немаловажно — команды работали не только со словами, но и с байтами. И в памяти так же можно было обращаться к отдельному байту, а не только слову.

Язык B был портирован на PDP-11, но его возможностей не хватало. И тогда к работе над языком подключился Деннис Ритчи. Так появился язык C. Тут важно акцентировать внимание на том, что вначале было железо, которое проектировалось исходя из соображений «а давайте еще и вот так зафигарим, круто же». А язык допиливался, чтобы покрыть функционал уже существующего железа. И многие решения по языку были продиктованы этим самым железом.

Язык оказался небольшим, понятным, низкоуровневым и удачным, так как достаточно быстро был портирован на другие системы. Язык был невероятно низкоуровневым для того времени. Интересующиеся могут ознакомиться с алголом и фортраном:) Эффективность кода, который он порождал, была гораздо выше. И главная киллер-фича — можно переносить программы простой перекомпиляцией. Ну почти:) Потом были написаны терабайты софта на C, и так язык стал гегемоном. А после плюсов все вообще пошло под откос :)

Если сравнить архитектуру и систему команд PDP-11 с более поздними процессорами, то критике можно подвергнуть два момента. Во-первых, мало регистров. Их всего 8, при этом два заняты указателем текущей команды и верхушки стека. То есть у программиста остается всего 6. Локальные переменные на регистрах особо не поразмещаешь — они (регистры) быстро закончатся. И во-вторых, система адресации хоть и ортогональна, но несколько избыточна и сложна. Но с другой стороны а что делать если переменные по большей части в памяти или стеке? С ними же надо как-то работать.

Позже, в 80-е и далее в 90-е архитектура процессоров была существенно переосмыслена. Стали считать, что регистров надо больше — это позволяет хранить локальные переменные не на стеке, а в регистрах и работать с ними быстрее. А вот сложных команд, которые работают память-память, надо избегать. Команды должны быть простые, прогнозируемые и выполняться за один-два такта. Квинтэссенцией упрощения архитектуры стал RISC/MIPS. (Конечно не все были с этим согласны. Интел например продолжал пилить своего легаси монстра х86, что тоже изрядно повлияло на индустрию, но об этом в другой раз :)

И вот мне тут подумалось как-то: а что было бы, если бы PDP-11 была другой? Тогда, возможно, и язык C выглядел бы иначе? Однозначно иначе. Но как?
UR5FFR
Site Admin
Posts: 2365
Joined: 21 Apr 2012, 22:00
Позывной: UR5FFR
Location: Odessa

Re: Поворот в не туда или Как написать тетрис не привлекая внимания санитаров

Post by UR5FFR »

Итак приступим. Я буду проектировать архитектуру исходя из технических возможностей которые были доступны во времена создания PDP-11. Т.е. ничего экстраординарного и нвевероятного, никаких квантовых ускорителей и FPGA не будет. Все предельно просто с прицелом на легкую микропрограммную реализацию хоть на россыпухе из 155й серии.

У PDP-11 было 8 регистров шириной в 16ти битное слово. И этого очень мало для эффективной работы. Поэтому в моем процессоре будет 16 регистров. Шириной все те же самые 16 бит. И чтобы компилятор не умер от счастья часть из этих регистров мы займем под регистры специального назначения. У PDP-11 это регистр казателя стека SP и текущей инструкции IP. Мы не будем большими оригиналами и сохраним эти регистры. Но добавим еще два - регистр флагов FLAGS и регистр связи LR.

Разберемся подробнее что это нам дает. Регистр флагов как один из регистров общего назначения позволяет сократить набор команд исключив из него специфичные команды для работы с ним. Т.е. мы его можем пересылать в другие регистры и сохранять в стек точно так же как и любой другой регистр. О - Ортогональность.

Регистр связи LR используется следующим образом. Когда выполняется CALL он не ложит адрес возврата в стек, а просто сохраняет его в регистре LR. Подпрограмма в свою очередь для возврата просто пересылает значение из LR в IP. Но вся эта конструкция работает только если подпрограмма листовая, т.е. она не вызывает другие подпрограммы. Если вызовы есть то все же должны сохранить регистр связи LR в стеке и восстановить его перед возвратом. Это обычная техника используемая в RISC. Она экономит нам обращение к памяти через PUSH/POP для сохранения адреса возврата. И за счет этого мы минимизируем затраты на вызов маленьких листовых подпрограмм.

PDP-11 имеет три типа команд (под типом подразумевается распределение и функциональное назначенией полей в инструкции). У моего процессора изначально был только один тип :) М - Минимализм

Code: Select all

 15      11 10    7 6     3 2     0
| OPCODE:5 | R1:4  | R2:4  | R2MOD:3 |
Вкратце логика исполнения команды очень простая. Код операции задается полем OPCODE. Всего может быть 32 различных вида операций. Первый операнд берется всегда из регистра R1. Второй операнд может браться как из регистра R2, так и из памяти или быть константой. Это определяется типом адресации который задается в поле R2MOD. Всего может быть 8 разных типов адресации и они все задействованы.
Результат операции помещается в регистр R1.

Есть несколько исключений. Команды сохранения в память сохраняют регистр R1 по адресу который определяется полем R2MOD+R2. Команда обмена (XCHG) обменивает значение регистра R1 и памяти R2MOD+R2. Некоторые команды могут не использовтаь поля R1, R2 и R2MOD, либо трактовать их иначе.

Для команд условного перехода регистр R1 содержит 4 бита кода условия. А адрес перехода определяется комбинацией R2MOD+R2.

Как я уже писал выше поле R2MOD определяет тип адресации второго операнда. Всего может быть 8 разных типов адресации

Code: Select all

|   Запись  |           Операнд                 |      Пример      |
|-----------|-----------------------------------|------------------|
| R1        | значение регистра                 | ADD R0, R1       |
| #выр      | константа                         | ADD R0, #100     |
| [R1]      | слово по адресу R1                | LD R0, [R1]      |
| [R1++]    | слово по адресу R1, затем R1 += 2 | ADD R0, [R1++]   |
| [--R1]    | R1 ?= 2, затем слово по адресу R1 | LD R0, [--R1]    |
| [адрес]   | слово по абсолютному адресу       | LD R0, [counter] |
| [R1+выр]  | слово по адресу R1 + смещение     | LD R0, [R1+4]    |
| R1+выр    | сумма без обращения к памяти      | LEA R0, R1+4     |
|-----------|-----------------------------------|------------------|
Что тут интересного:
- вторым операндом может идти короткая константа длиной 4 бита
- если нам нужна длинная 16ти битная константа или адрес то она идет вторым словом сразу после инструкици. А обращаемся мы к нему через [IP++]
- есть косвенная адресация
- есть преддекремент и постинкремент, т.е. конструкции вида --R1 и R1++. А так как регистр стека - это обычный регистр то операции PUSH и POP записываются через MOV R1, [SP++] и STO R1, [--SP] (стек растет вниз)
- есть косвенная адресация с дополнительным смещением. Это дает возможность адресовать как переменные на стеке (ADD R2, [SP+4]) так и константы рядом с кодом (XOR R4, [IP+24]).

Теперь коснемся немного модели памяти. Адресация происходит с точностью до байта. Его адрес невыровнен - т.е. может быть как четным так и нечетным. А вот слова в памяти все должны располагаться по четным адресам, т.е. выровнено. Инструкции процессора точно так же располагаются с выравниванием. При чтении/записи слова из памяти младший бит адреса попросту игнорируется. Никаких прерываний как в PDP-11 не происходит.

Все регистры процессора 16ти битные. Все операции над ними так же 16ти витные. За исключением загрузки и выгрузки. Они есть для байтовых данных. При загрузке байта он попадает в младшую половину слова. А старшая часть либо обнуляется либо получает знаковое расширение. Т.е. нам надо две команды загрузки байта. И одна команда выгрузки, которая сохраняет байт из младшей половины слова.

Для сравнения в PDP-11 все команды обрабатывающие данные имеют отдельный флаг который говорит о том какую ширину они имеют - слово или байт. Вроде и казалось бы логично, но на практике - избыточно.

Продолжение следует ...
UR5FFR
Site Admin
Posts: 2365
Joined: 21 Apr 2012, 22:00
Позывной: UR5FFR
Location: Odessa

Re: Поворот в не туда или Как написать тетрис не привлекая внимания санитаров

Post by UR5FFR »

Вся эта идея была за один вечер зафиксирована в виде черновика на несколько страниц текста
➕ Черновик описания системы команд
Размер слова - 16 бит.
16 регистров, каждый размером в слово.
Все операции производятся над словами если не оговоренно противное.
Команда имеет длину одно или два слова.
Команды и данные в памяти всегда выровнены на границу слова
При обращении к данным размером в слово младший бит адреса игнорируется
Операции работы с байтами могут обращаться к байтам по любому (в т.ч. невыровненному) адресу
Порядок байт в слове little-endian.

специальные регистры:
R12 - LR (link register)
R13 - SP (указатель вершины стека, растет вниз)
R14 - IP
R15 - FLAGS

*** ФЛАГИ

Стандартный набор флагов для арифметики ZF, CF, SF, OF.
Флаг разрешения прерываний IF (0 - запрещены, 1 - разрешены)
Порядок флагов в регистре от младшего к старшему:

0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
| ZF | CF | SF | OF | IF | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |

Регистр флагов полноправный регистр для чтения/записи.
Команды установки/сброса флагов реализуются через битовые операции с ним.

*** ПРЕРЫВАНИЯ

При внешнем прерывании в стеке сохраняется текущий IP и регистр флагов. Сбрасывается бит разрешения прерываний.
Таблица обработчиков прерываний расположена по адресу $FF00 и содержит 16 слов.
Каждый элемент таблицы содержит адрес обработчика.
Обработчики с 0 по 7 мапятся на внешние запросы прерываний
Обработчики с 8 по 15 используются для программных вызовов и ошибок

Прерывание 8 (ERRCMD) вызывается при неверном опкоде или недопустимой адресации

*** ОПИСАНИЕ КОМАНД

Все команды имеют единый формат

OPCODE:5 R1:4 R2:4 R2MOD:3

R2MOD:
0 - reg (аргумент - значение регистра)
1 - поле R2 трактуется как короткая беззнаковая константа 4bit
2 - [reg] взять слово по адресу который расположен в R2
3 - [reg++] (аналогично 2 но с постинкрементом. если reg==IP то загружаем слово после команды и увеличиваем IP на 2)
4 - [--reg] (аналогично 2 но с преддекрементом)
5 - [disp] (абсолютная адресация)
6 - [reg+disp] (относительная адресация)
7 - reg+disp (сумма значения регистра и disp. используется для LEA и относительной адресации в переходах и вызовах подпрограмм)

disp - слово следующее за командой (длина команды два слова)

автоинкремент/декремент всегда на 2.
на 1 только в случае байтовых команд STB, LDSX, LDZX, XCHB

MOD=2,3,4,6,7 совместно с регистром флагов (R2==R15) вызывает прерывание ERRCMD

После извлечения команды IP всегда указывает на следующее после команды слово

OPCODE:

=== Загрузка/выгрузка/обмен

ST - выгружает слово R1 по адресу в R2 с учетом MOD. флаги без изменений.
STB - выгружает младший байт из R1 по адресу в R2 с учетом MOD. флаги без изменений.

XCHB - обмен байта R1 по адресу в R2 с учетом MOD. атомарная операция. флаги без изменений.

Команды XCHB, ST и STB вызывают прерывание ERRCMD при использовании с MOD=0,1,7
а так же MOD=2,3,4 совместно с IP (R2==R14)

LD - загрузка слова в R1. флаги без изменений.

LDSX, LDZX - загрузка байтов в R1 с/без знакового расширения. флаги без изменений.
Байтовая загрузка вызывают прерывание ERRCMD при MOD=3,4 совместно с IP/SP (R2==R13 || R2==R14)

=== Арифметика и логика

Если R1 является R15, флаги АЛУ не обновляются автоматически; регистр принимает ровно то значение, которое в него записано

ADD, SUB, ADC, SBC - результат в R1. влияет на все флаги
AND, OR, XOR - результат в R1. меняет ZF, SF, CF=0, OF=0;

CMP - эквивалентно SUB но в R1 не пишет, только меняет флаги
TEST - эквивалентно AND но в R1 не пишет, только меняет флаги ZF/SF по результату, CF=0, OF=0

величина сдвига - младшие 4 бита из аргумента R2+MOD. источник и результат в R1
SHL, SHR - логические сдвиги влево/вправо
SAR - арифметический вправо
ROR - циклический вправо

NEG - эквивалентно 0-R1. R2 и MOD игнорируется. влияет на все флаги
NOT - R1=~R1. R2 и MOD игнорируется. флаги не меняет
BSX (знаковое расширение мл. байта) - над R1. R2 и MOD игнорируется. флаги не меняет

=== Передача управления

R2MOD=0 - адрес перехода в регистре
R2MOD=2 - адрес перехода по слову адрес которого в регистре (косвенная)
R2=IP R2MOD=3 - адрес во втором слове команды
R2MOD=5 - адрес перехода по слову адрес которого идет вторым словом команды
R2MOD=6 - адрес перехода по слову адрес которого в регистре+смещение
R2=IP R2MOD=7 - адрес относительно IP, смещение во втором слове команды

Jxx (в R1 условие 15 кодов), адрес перехода вычисляется стандартно R2+MOD. флаги без изменений.

JCode - условия для переходов
0000 JMP Безусловный переход
0001 JZ / JE Равно / Нуль ZF = 1
0010 JNZ / JNE Не равно / Не нуль ZF = 0
0011 JC / JB Перенос / Ниже (беззнак.) CF = 1
0100 JNC / JAE Нет переноса / Выше или равно CF = 0
0101 JA Выше (беззнак.) CF = 0 и ZF = 0
0110 JBE Ниже или равно (беззнак.) CF = 1 или ZF = 1
0111 JS Знак (отрицательное) SF = 1
1000 JNS Нет знака (положительное) SF = 0
1001 JO Переполнение OF = 1
1010 JNO Нет переполнения OF = 0
1011 JL Меньше (знак.) SF != OF
1100 JGE Больше или равно (знак.) SF = OF
1101 JG Больше (знак.) ZF = 0 и SF = OF
1110 JLE Меньше или равно (знак.) ZF = 1 или SF != OF
1111 резерв

CALL - R1 игнорируется, R2+MOD - адрес перехода. Адрес возврата в регистр связи LR=IP; IP=addr. Стек не используется. Флаги не меняются

TRAP - R1 игнорируется, вектор прерывания R2+MOD (младшие 4 бита). Семантика: PUSH IP; PUSH FLAGS; FLAGS.IF=0; LOAD IP, [$FF00 + (addr & $F)*2]
IRET - R1,R2+MOD игнорируется. POP FLAGS; POP IP

*** ПСЕВДОКОМАНДЫ

Из за ортогональности системы команд и гибкого использования регистров некоторые команды являются алиасами
и не имеют отдельного опкода.

RET эквивалентно загрузке в IP значения из LR (LD IP, LR)
PUSH R ST [--SP], R
POP R LD R, [SP++]

*** НАЧАЛЬНОЕ СОСТОЯНИЕ ПОСЛЕ РЕСЕТА

Все регистры (кроме SP) и регистр флагов имеют нулевое значение (прерывания запрещены).
Управление передается по нулевому адресу.
Т.к. указатель стека нулевой то первым делом надо его инициализировать (например $FF00).
Но так как писать документацию для программиста это самое ненавистное из занятий то я скормил этот драфт ИИ клауди. Она бодренько так отрапортовала что в общем-то неплохо, но можно сделать много разного улучшайзинга. И тут ее пришлось основательно притормаживать, потому как ее идеи превращали исходную концепцию в смесь бульдога с носорогом. В итоге за вечер архитектура была уточнена и на нее написана полная спецификация. И все было хорошо - светило солнце, пели птички. Ничто не предвещало беды. И тут клауди спросила - а хочешь я напишу эмулятор? :)
Небольшая ремарка. Я достаточно скептически отношусь к возможностям ИИ по написанию кода. Да, они что-то пишут, оно даже работает но обычно требует доработки напильником и не всегда соответствует тому что ты хотел получить.
Учитывая сложность задачи я воспринял это с изрядной долей скептицизма. Но все же решил - а почему бы и нет? Пусть попробует. Может у нее что-то и получится. Рабочее :)

Каково же было мое удивление когда через пять минут я стал обладателем архива который содержал эмулятор процессора. И тут Остапа понесло :) Чтобы запустить код на эмуляторе нужен ассемблер - не писать же вручную бинарные коды. Поэтому первым делом була написана спецификация на язык ассемблера для этого процессора. Потом собственно сам ассемблер. Так как спецификации - это тяжелая для чтения канцелярщина то было написано и введение на языке кожанных мешков понятном человекам Из устройств ввода-вывода (которые мапятся на память) была пока только обычная текстовая консоль. Поигравшись немного с эмулятором в командной строке я понял что этого "маловато будет". И попросил клауди написать на джаваскрипте интерактивный дебагер, который бы запускался в браузере. И выглядел так как выглядит окно отладчика в режиме CPU в Дельфи. Каково же было мое удивление когда все получилось именно так как я себе и представлял. Да еще и рабочее :)
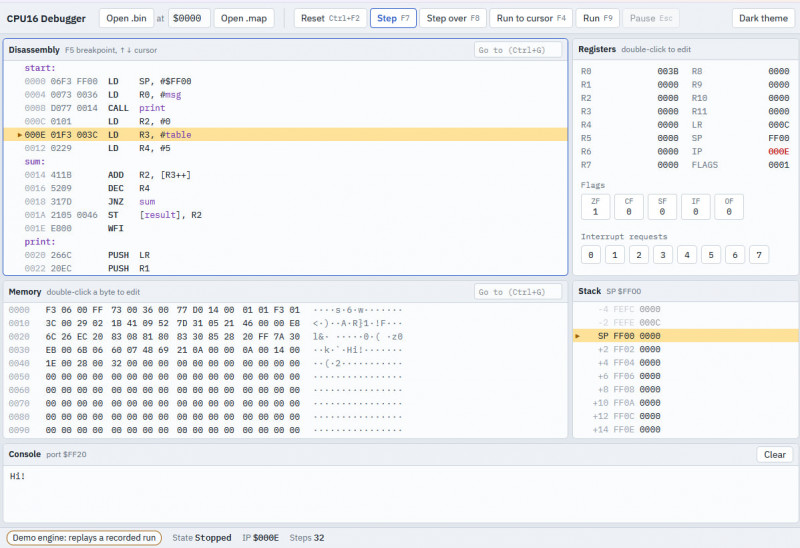
photo_2026-10-05_22-20-27.jpg
Дальше как говориться аппетит начал приходить во время еды. Виртуальная машина была дополнена таймером и устройством текстового цветного дисплея. Было принято решение не отображать фреймбуфер на память, которой и так не много (всего 64к) а сделать работу с ним через порты ввода-вывода. Т.е. в регистр пишется адрес а потом в регистр данных пишутся символы. Кодовую страницу клауди предлагала взять 866ю. Это меня категорически не устраивало и я предложил 1251. На что она ехидненько так заметила что в 1251 нет символов псевдографики для рисования рамочек и прочего. Не вопрос. Легкое движение руки и страница 1251 была дополнена двумя блоками псевдографики из КОИ-8.
Кроме этого в веб-отладчик был добавлен ассмеблер, чтобы можно было писать и править код сразу "не отходя от кассы".
photo_2026-10-17_17-14-32.jpg
Ну и как же без ретрогейминга когда у нас уже все есть готовое? :) Пять минут и готова "змейка" :) Жрет символы и и растет
Screenshot_2026_10_17-1.png
Ну и то ради чего все собственно и затевалось - конечно же тетрис. Причем еще и с встроенным демо режимом, когда программа умеет играть в него сама
Screenshot_2026_10_17-2.png
Я не написал ни одной строчки кода - чистый вайб :) Я руковожу процессом, вычитываю спецификации, принимаю архитектурные решения, корректирую там где есть разные варианты решений. Но код и документацию не пишу принципиально. Цель - понять что она (клауди) может и где пределы ее возможностей.

Кому интересно самому поклацать - в архиве документация, веб-отладчик с ассемблером и демо примеры. Текст примера копируем в окно редактора, жмем Build и Run. Для программ которые требуют полноэкранный режим надо дополнительно открыть дисплей нажав кнопку Display справа внизу. Дисплей открывается в отдельном окне - проверьте что ваш браузер разрешает это.
u16.zip
(146.17 KiB) Downloaded 5 times
Если кто-то думает что это все, то это не так :) Описано то что было по состоянию на 10 днйе назад.
С тех пор утекло много воды в проекте появилось много чего интересного и вкусного. Так что
Продолжение следует ...
Locked